Взломанная PS5 запускает локальные ИИ-модели: до 124 токенов в секунду на GPU
Пользователь Reddit u/AdIllustrious7246 доработал порт llama.cpp для взломанной PS5: теперь он работает нативно и задействует GPU, что позволило запускать куда более крупные ИИ-модели.
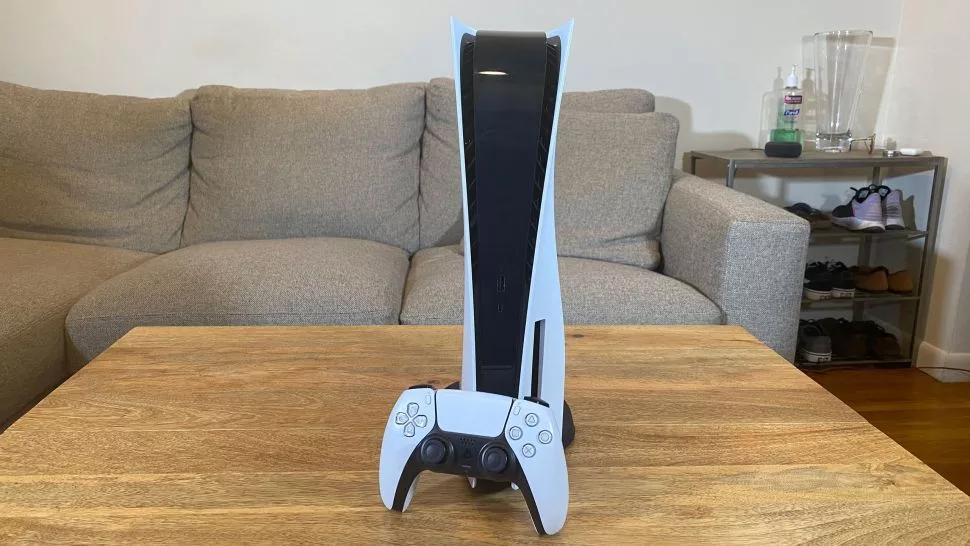
Список того, что умеет консоль PlayStation 5 после взлома, пополнился. Пользователь Reddit u/AdIllustrious7246 выложил собственный форк проекта PS5LM — порта llama.cpp, который позволяет запускать языковые модели прямо на приставке. Главное улучшение: приложение работает нативно и использует GPU, поэтому справляется с крупными моделями вроде Qwen3.8-27B со скоростью около 20 токенов в секунду.
С чего всё началось
Исходный неофициальный порт llama.cpp для PS5 две недели назад на Reddit опубликовал разработчик с ником cobanov. Его версия работала как payload на CPU и была ограничена примерно 6,25 ГиБ памяти. Такой запуск по сути перехватывает процессор и встраивает модель в поток инструкций рядом с домашним экраном и системными службами. Если выделить больше памяти, домашний экран зависает. Cobanov хотел как можно быстрее получить рабочий llama.cpp, а позже планировал подключить GPU для более крупных моделей, но его опередил u/AdIllustrious7246.
Как удалось задействовать GPU
Автор форка использовал PS5_Vulkan — порт графического драйвера RADV, который позволяет отправлять команды на GPU консоли. Обычно графический процессор PS5 закрыт и недоступен так, как видеокарта в ПК, хотя это решение AMD. PS5_Vulkan открыл доступ к GPU и сделал возможными многие хобби-проекты, включая запуск языковых моделей.
Что получилось в цифрах
Теперь llama.cpp работает нативно, полностью использует GPU и получает больше оперативной памяти — до 11,4 ГиБ. Результаты, по словам автора:
- модель на 27 млрд параметров — около 20 токенов в секунду;
- Gemma 4 E4B — 61 токен в секунду;
- Llama 3.2 3B — 124 токена в секунду.
Раньше модель размером 6,8 ГиБ вызывала зависание и сбой системы из-за узкого места в виде CPU. GPU значительно лучше подходят для обработки языковых моделей — именно поэтому цены на видеокарты и память сейчас так высоки.
Дашборд и веб-интерфейс
Разработчик также добавил панель мониторинга. Она показывает скорость генерации токенов в реальном времени, нагрузку на GPU и CPU, энергопотребление, температуры и распределение памяти между моделью и KV-кэшем. Кроме того, форк совместим с веб-интерфейсом llama.cpp, так что общаться с моделью можно из браузера на других устройствах в локальной сети.
Повторится ли история с майнингом
Идея превратить PS5 в ИИ-ассистента, когда она не занята играми, впечатляет, а комментаторы уже вспоминают кризис видеокарт из-за криптомайнинга. Но повторение маловероятно: дефицит GPU и памяти и так вызван спросом со стороны крупных ИИ-дата-центров, а у PS5 нет ни самого быстрого графического процессора, ни особенно большого объёма памяти.