AMD и Intel объединят оптимизации PyTorch для ИИ-инференса на CPU
AMD и Intel договорились объединить оптимизации для запуска ИИ-моделей в PyTorch на центральных процессорах. Общая библиотека oneDNN будет автоматически подбирать ускоренные ядра под чипы обеих компаний.
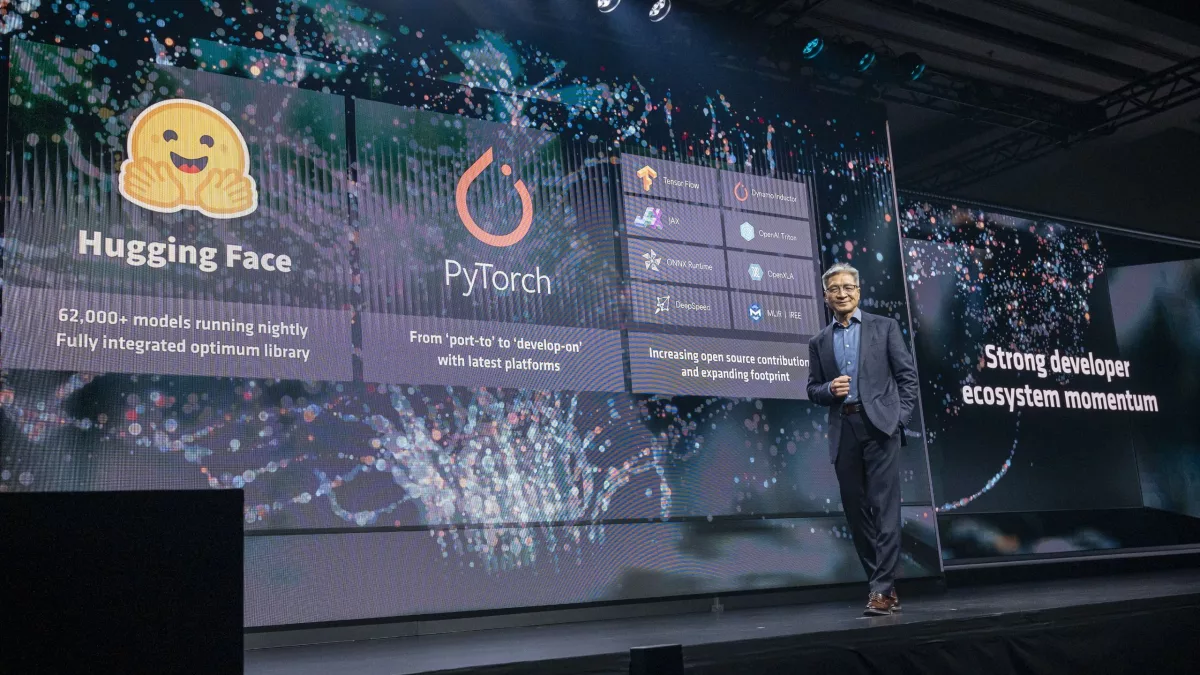
AMD и Intel объединят работу над оптимизациями PyTorch для ИИ-инференса на центральных процессорах. Вместо отдельных решений разработчикам предложат единый backend на базе открытой библиотеки oneDNN: он будет учитывать возможности как актуальных CPU Intel, так и процессоров AMD.
Главная практическая цель инициативы — избавить разработчиков от необходимости отдельно подбирать программные оптимизации под разные x86-платформы. При использовании PyTorch один и тот же backend должен определить доступные аппаратные функции во время запуска и задействовать наиболее подходящие оптимизированные ядра для установленного процессора.
ZenDNN войдёт в основной проект oneDNN
До этого AMD поддерживала ZenDNN — собственную downstream-версию oneDNN. Теперь наработки ZenDNN переносятся в основной открытый проект oneDNN. Библиотека публикуется UXL Foundation и изначально развивалась Intel, которая создала oneDNN на основе более ранних библиотек для глубокого обучения.
Одновременно AMD присоединяется к UXL Foundation в качестве steering member — участника, который влияет на дальнейшее развитие организации. Для этого статуса компания будет вносить $20,000 в год. Среди основателей UXL Foundation также находятся Intel, Arm, Qualcomm, Google Cloud и другие компании.
Объединение рекомендовал x86 Ecosystem Advisory Group, или EAG. Это совместная инициатива Intel и AMD, созданная в 2024 году для развития экосистемы архитектуры x86. Компании уже работали через EAG: в частности, группа участвовала в разработке расширений ACE для x86, о которых стало известно ранее в этом году.
Что ускоряет oneDNN
Backend oneDNN предназначен для инференса на CPU — этапа, когда уже обученная нейросеть обрабатывает новые данные и выдаёт результат. Это может быть, например, работа локальной модели с текстом, изображением или другими запросами. Библиотека оптимизирует такие нагрузки в фреймворках машинного обучения, включая PyTorch.
Согласно описанию проекта, oneDNN определяет аппаратные возможности системы во время выполнения, генерирует оптимизированные для конкретной платформы ядра и поддерживает форматы данных с пониженной точностью. В ней также есть ускоренные инструкции для типичных операций машинного обучения — матричного умножения и свёртки.
Когда oneDNN добавили в PyTorch как backend в конце 2023 года, он показывал ускорение в 1,24 раза при работе с данными Float32 и в 2,21 раза при использовании BFloat16. Эти цифры относятся к внедрению oneDNN в PyTorch; новая интеграция оптимизаций AMD должна расширить поддержку процессоров, но конкретных результатов для CPU AMD пока не раскрыто.
Единый путь для x86 и не только
Для разработчиков изменение означает единый программный путь для CPU Intel и AMD в PyTorch. Вместо выбора между независимыми наборами оптимизаций backend сможет сам применить подходящие ускорения для доступного оборудования. Это особенно важно для проектов, которые разворачиваются на разных рабочих станциях и серверных системах.
Хотя соглашение AMD и Intel сосредоточено на x86-процессорах, сама oneDNN не ограничивается этой архитектурой. Библиотека является кроссплатформенной и также работает с Arm и RISC-V. Объединение двух крупнейших производителей x86-чипов при этом должно сделать запуск ИИ-инференса на CPU более предсказуемым и удобным для разработчиков PyTorch.